Gemini 新モデルの Orchestrator モードをはじめとする開発エージェントと長時間対話していると、「序盤は快適だったのに、後半になるほど返答が極端に遅くなり、トークン消費も跳ね上がる」と感じたことはないでしょうか。
多くの方は「最初のシステム指示が長すぎるせいだ」と疑いますが、ボトルネックの本質は別の場所にあります。分厚い議事録を付箋の位置から再開するのではなく、毎回1ページ目から全員で音読し直すような状態が起きているのです。
本記事では、主要プロバイダのキャッシュ仕様をもとに、遅延(TTFT)とコスト悪化の正体である「コンテキスト肥大×KVキャッシュ全損」の仕組みと、単一モデル固定・Orchestrator・Swarmの使い分け、すぐ導入できる汎用コンテキスト衛生ルールを解説します。
> ※本記事にはアフィリエイト広告およびプロモーションが含まれています。
トークン爆発と遅延の正体:コンテキスト肥大(94%)× KVキャッシュ全損
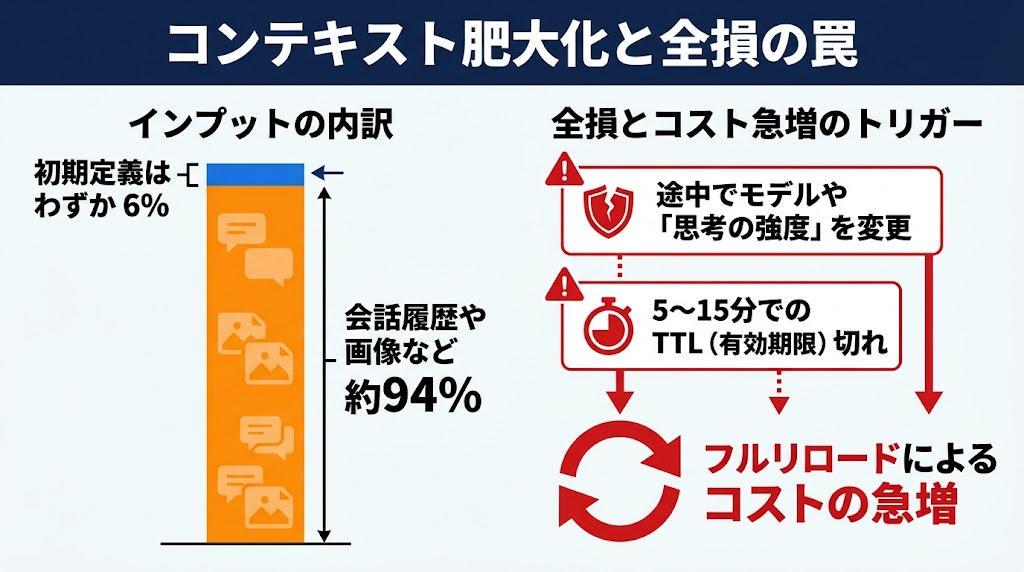
LLMエージェントが毎ターンAPIへ送信するデータ内訳を見ると、重さの比率が明確に分かります。
初期定義(約6%)より重い「長期履歴と画像」(約94%)
たとえば初期定義が約6,000トークンで、長時間の作業を経て履歴や画像が9万トークン超へ膨らんだ合計10万トークン規模のセッションを想定すると、システムプロンプトやスキル定義は全体の約6%にすぎません。残りの約94%を占めるのは、ターンを重ねて蓄積した過去の会話、コード差分、実行ログ、読み込んだ画像データです。LLMはステートレスなため、1行の追加指示でも過去履歴すべてを先頭から送り直します。
同一条件なら約90%ヒットするKVキャッシュと3大破壊トリガー
Anthropic、OpenAI、Google Geminiの各APIは、プロンプト先頭が一致する部分について計算済みのKV(Key-Value)テンソルを保持します。同一モデル・同一設定を保てば約90%の入力トークンでキャッシュヒットし、重いPrefill計算を省いてTTFT(初回応答時間)と入力単価(最大90%割引・0.1倍)を劇的に抑えられます。
しかし、先頭からの整合性が崩れる以下3つの操作でキャッシュは一撃で全損(Cold Prefill)します。
- 会話途中でのモデル切替:キャッシュはモデルID単位で隔離されています。同一スレッドのまま上位モデルと軽量モデルを切り替えると、履歴全量がキャッシュミスになります。
- Thinking Effortの途中変更:同じモデル系でも、会話途中で推論強度(例:MediumからXHigh)を変更すると構造境界が変わり、下流キャッシュがリセットされやすくなります。
- 5〜15分以上の待機(TTL失効):Anthropicの標準5分TTLなど短い有効期限を過ぎて同じスレッドで再開すると、肥大した約94%の履歴を最初から読み直す羽目になります(OpenAIは30分等の保持層、Geminiは負荷に応じた動的退避)。
【第1部】単一モデル固定 vs Orchestrator vs Swarm の使い分け
適材適所でモデルを使いたい場合でも、実行トポロジーの選び方を誤るとコストと速度が逆転します。
Orchestrator(単一スレッド切替)の罠とSwarmの優位性
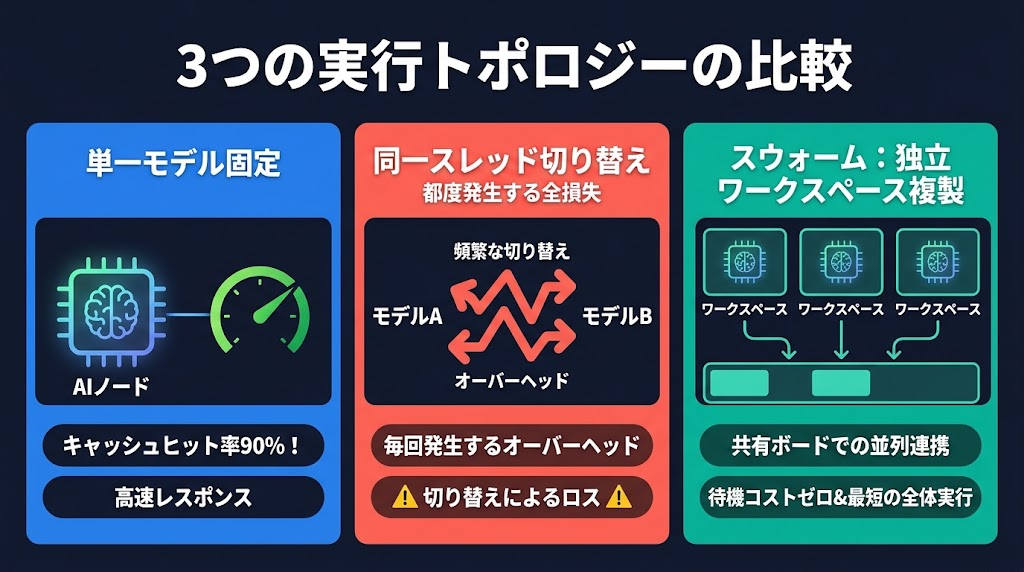
Gemini 新モデルの Orchestrator モードのように、1本の長い親スレッド(Orchestrator)の内部で「計画モデル⇄実装モデル」を小刻みに往復させる設計は、1つの会議室に担当者を次々入れ替えて毎回資料を読み直させるようなものです。肥大した履歴を抱えたまま毎回キャッシュ全損を起こすため、後半ほど激しく遅延します。
一方、Swarm(並列スウォーム協調)はホワイトボード上の付箋メモだけで連絡し、各自の机のクリーンな状態で作業する設計です。各ワーカーへ隔離された作業用コピー(Git worktreeや独立ブランチなど)とクリーンな初期コンテキストを割り当て、共有メッセージボードと成果物ファイルのみで連携します。待機中のワーカーは課金ゼロのため、重い履歴を引きずりません。
3トポロジー比較表と判断基準
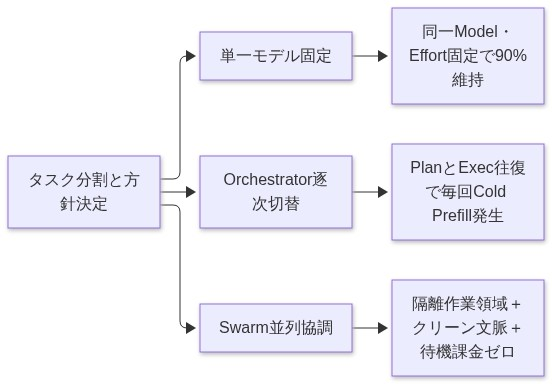
| 比較軸 | 単一モデル固定 | Orchestrator(単一スレッド切替) | Swarm(隔離並列+共有ボード) |
|---|---|---|---|
| コンテキスト量 | 中(単一タスク完結) | 極大(全履歴・画像を蓄積) | 最小(担当範囲のみ読込) |
| KVキャッシュ効率 | 最高(約90%連続ヒット) | 最低(切替の度に全損) | 高(クリーン文脈で高速起動) |
| 待機コスト・TTFT | 高速(Prefill最小) | 後半ほど激遅・高額化 | 待機課金ゼロ・並列で最短 |
| 推奨タスク規模 | 単一機能・小規模修正 | 短時間で終わる2〜3往復 | 複数ファイル改修・並列調査 |
迷ったらまず「単一モデル固定」でスレッドを短く保つのが最安・最速です。調査・実装・独立レビューを並走させる大型タスクのみ、Swarm型で文脈を分離してください。
【第2部】すぐ導入できる汎用コンテキスト衛生ルールと3つの罠
日々の開発ワークフローに以下のルールを組み込むだけで、キャッシュ全損を構造的に防げます。
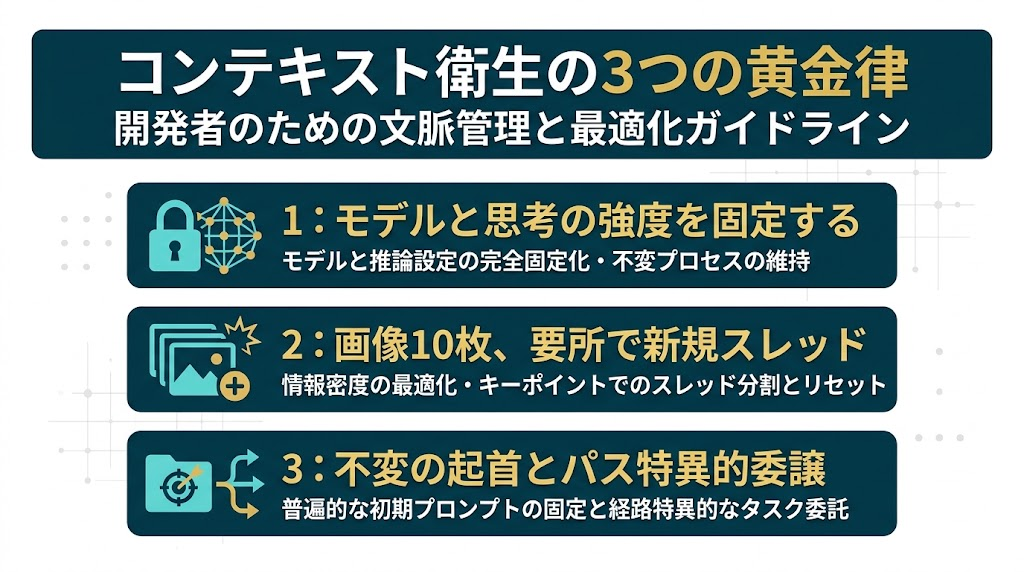
汎用コンテキスト衛生ルール(そのまま使えるYAML方針定義)
特定ツールの設定ファイルではなく、プロジェクトの指示書やシステムプロンプトへ組み込んでエージェントに守らせる汎用ポリシー定義テンプレートです。
context_hygiene_policy:
  version: "1.0"
  prefix_stability:
    keep_system_immutable: true           # システム指示の先頭固定(絶対変更しない)
    keep_tool_schemas_sorted: true        # ツール定義の順序・名称を固定
    forbid_dynamic_header_tokens: true    # 現在時刻やランダムUUIDの先頭混入を禁止
    pin_model_and_effort_per_thread: true # スレッド途中でのモデル/Thinking変更を禁止
  session_lifecycle:
    max_images_per_thread: 10             # 画像10枚以上(約1万トークン超)で新スレッドへ
    reset_on_phase_transition: true       # 画像確認・調査 -> コード改修時は要約し新規作成
    compact_after_git_milestone: true     # コミット等の節目で会話履歴をコンパクション
    ttl_idle_reset_minutes: 5             # 5〜15分放置(TTL失効)後の長会話再開を回避
  topology_routing:
    small_single_module: "single_sticky"  # 同一モデル・同一Effort固定で90%キャッシュ維持
    parallel_multi_module: "swarm_board"  # 隔離ワークコピー+共有ボード並列協調+待機0円
    avoid_in_thread_plan_exec_pingpong: true # 単一スレッド内でのPlan/Exec往復を禁止
  subagent_delegation:
    explicit_target_paths_only: true      # 全体丸読み禁止・対象ディレクトリ/行範囲を限定
    prefer_diff_stat_first: true          # 差分全文ではなく --stat で変更範囲を絞る
    return_compact_summary_only: true     # 生ログ全量ではなく要点サマリーのみ返却
isolate_heavy_writes: true # 同時編集・ビルドは隔離ワークコピーで実行Anthropicの設計指針でも、エージェント性能を保つ鍵は「不要になった履歴を捨て、最小の関連情報で推論させること」とされています。
実務で踏みやすい3つのキャッシュ破壊トラップ
- 先頭への動的値混入:システム定義の先頭に現在時刻や可変IDを入れるとプレフィックスが毎回不一致になります。Manusの実装知見の通り、可変値は必ず末尾へ置いてください。
- 画像大量読込後のThinking引上げ:画像を10枚以上(約1万トークン規模以上)読んだスレッドのままEffortを上げると、画像トークン全量の再計算が走ります。フェーズ切替や区切りのコミット後に新スレッドへ切り替えましょう。
- サブエージェントへの丸投げ探索:対象パスを絞らず差分全文を返させると親スレッドまで汚染されます。委譲時は対象パスと行範囲の限定が鉄則です。
【第3部】定量試算:キャッシュ維持 vs 全損でコストとTTFTはどう変わるか
Anthropic(標準5分TTL)等の公式価格倍率(通常入力 1.0×、書込 1.25×、読込 0.1×)を例に、10万トークンの履歴を抱えて5ターン対話した際の入力コストを試算します。
| 実行パターン(履歴10万トークン・5ターン) | ターン別の課金係数 | 5ターン合計(等価入力) | 相対コスト比(比較目安) | TTFT傾向 |
|---|---|---|---|---|
| キャッシュ無(都度全損) | 1.0× × 5回 | 50.0万トークン相当 | 100%(基準) | 毎回最大遅延 |
| 同一モデル固定・TTL内連続 | 1.25× + 0.1× × 4回 | 16.5万トークン相当 | 約33%(約1/3) | 50〜80%短縮 |
| 5ターン中2回モデル/Effort切替 | 1.25× × 3 + 0.1× × 2 | 39.5万トークン相当 | 約79%(維持時比 2.4倍) | 切替毎に遅延 |
(※上記倍率に基づく構造比較の試算値です。出力トークンや追加増分は除いています)
同一モデルでキャッシュを維持すればコストが約3分の1になるだけでなく、OpenAIガイドが示す通りPrefill計算が省かれTTFTも50〜80%短縮されます。実際の運用ではAPIレスポンス等の cache_read_input_tokens と cache_creation_input_tokens の比率を観測すると、全損箇所をすぐ特定できます。
📖 さらに理解を深めたい方へ!おすすめの関連書籍
本記事で解説した「コンテキスト設計の原理・KVキャッシュ最適化・AIエージェントの本番運用」をより体系的に学べる厳選2冊です。
💡 入門・原理から学びたい方向け
LLMへの入力情報であるコンテキストをいかに構造化・圧縮・制御すれば精度と効率を両立できるかを原理から丁寧に解説。本記事で紹介したコンテキスト衛生や履歴管理の考え方を基礎から体系的に固めたい方に最適な一冊です。
💡 実践・本番設計を深めたい方向け
基盤モデルを用いた本番システムの設計原則から、推論レイテンシ(TTFT)削減、KVキャッシュ活用、コスト管理・評価手法までを網羅した決定版。トポロジー選定やAPIコスト最適化を実務レベルへ引き上げるための必携書です。
まとめ:スレッドを短く保ち、実行トポロジーを戦略的に使い分けよう
長会話でAI開発が遅く・高くなる原因は、「約94%を占めるコンテキスト肥大」と「モデル切替・Thinking変更・TTL失効によるKVキャッシュ全損」の掛け算です。
今日から実践できる改善アクションは次の3点に集約されます。
- 同一スレッド内ではモデルとThinking Effortを固定する
- 画像10枚以上の読込・フェーズ切替・5〜15分超の待機後は新スレッドに切り替える
- 小規模作業は単一モデル固定、並列・大型作業はSwarmを使い分ける
プロンプトを微調整する前に、まずは「キャッシュが壊れないスレッド運用」と「トポロジー選定」を整えてみてください。マルチエージェントの役割境界や実行制御設計は、以下の記事も参考になります。

コメント