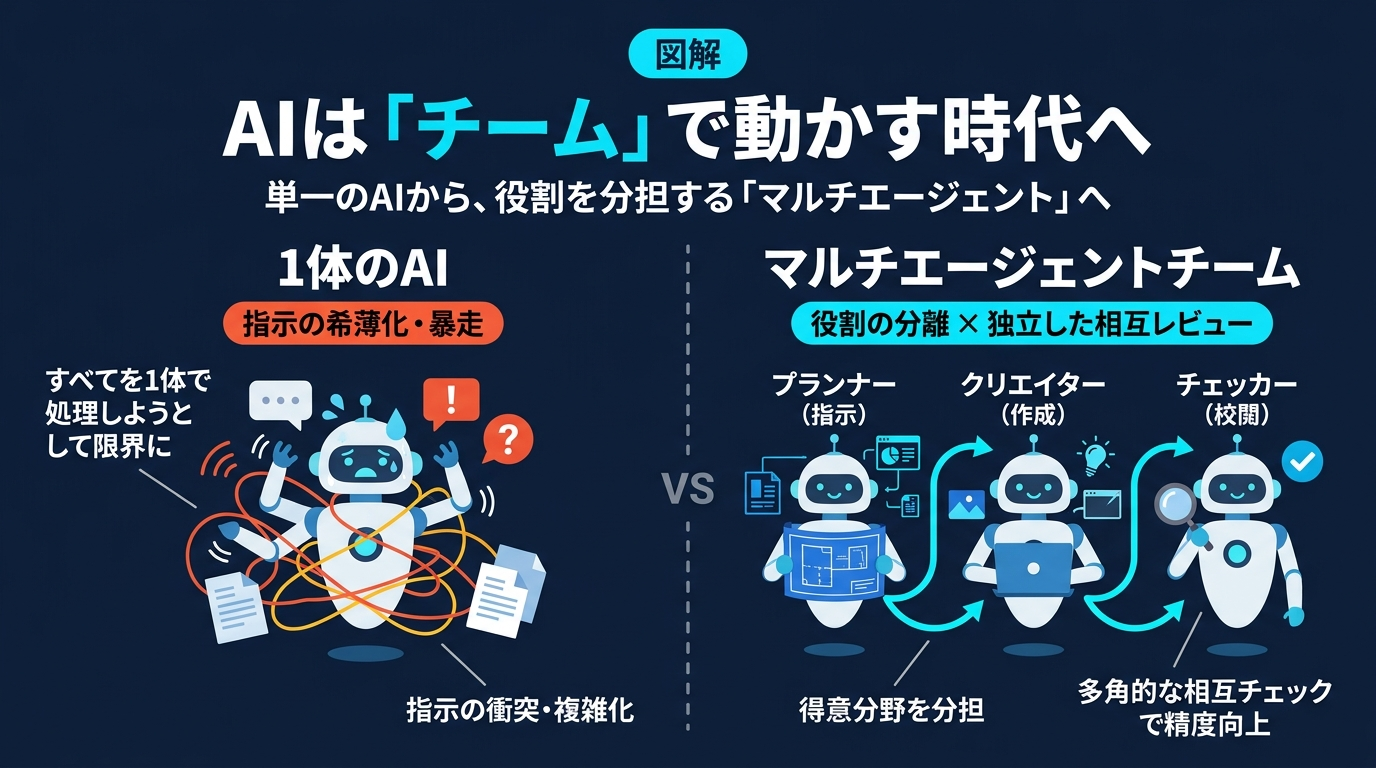
「調査から執筆、コード実装、外部操作まで優秀なAI1体に任せれば自動化できるはず」——そう考えて長大なプロンプトを組んだ結果、途中で制約が無視されたり誤りが素通りしたりした経験はないでしょうか。
1体のAIに複数の責務を背負わせる設計には構造的な限界があります。人間でいえば、1人に「取材・執筆・校閲・入稿」を同時に任せるようなものです。
本記事では、公式ガイドと学術研究の知見から1体のAIが破綻する理由を整理し、「役割分離×単一執筆×拒否権付き独立査読」で品質を安定させる汎用設計原則を解説します。
> ※本記事にはアフィリエイト広告およびプロモーションが含まれています。
なぜ「優秀な1体のAI」に全部任せると破綻するのか?
最新のLLMは長文を扱えますが、単一エージェントへ責務を詰め込むほど出力は不安定になります。
コンテキスト肥大化による「指示の希釈」と出力の不安定化
1つのプロンプトに調査手順・資料・禁止事項を詰め込むと、中盤の制約ほど見落とされやすくなります。論文『Lost in the Middle』では、LLMは入力の先頭と末尾は高精度に参照できる一方、中央部の情報ほど参照精度が落ちる「U字型」の特性が示されています。資料や会話が増えるほど初期ルールは希釈されます。
「自分で書いたものを自分で採点できない」自己確証バイアスの壁
「出力後に自分でチェックして直して」と頼んでも、単独では品質は安定しません。論文『Large Language Models Cannot Self-Correct Reasoning Yet』は、外部フィードバックなしの自己修正では推論精度が上がらず、かえって正解を誤答へ書き換えて性能が劣化するケースがあると指摘しています。同一文脈では自己確証バイアスから抜け出せません。
すべてを1つのプロンプトに詰め込む設計が陥る保守性の破綻
Anthropicの『Building effective agents』やGoogle Cloudの『設計パターン選定ガイド』でも、1体に多数のツールや役割を詰め込むと推論負荷が跳ね上がり、誤選択・遅延・デバッグ困難を招くと整理されています。
「人間の編集チーム」から学ぶマルチエージェント役割分離の原則
設計の要はエージェント数ではなく、「どこでコンテキストを分離し、どこを1体に統合するか」の境界設計です。
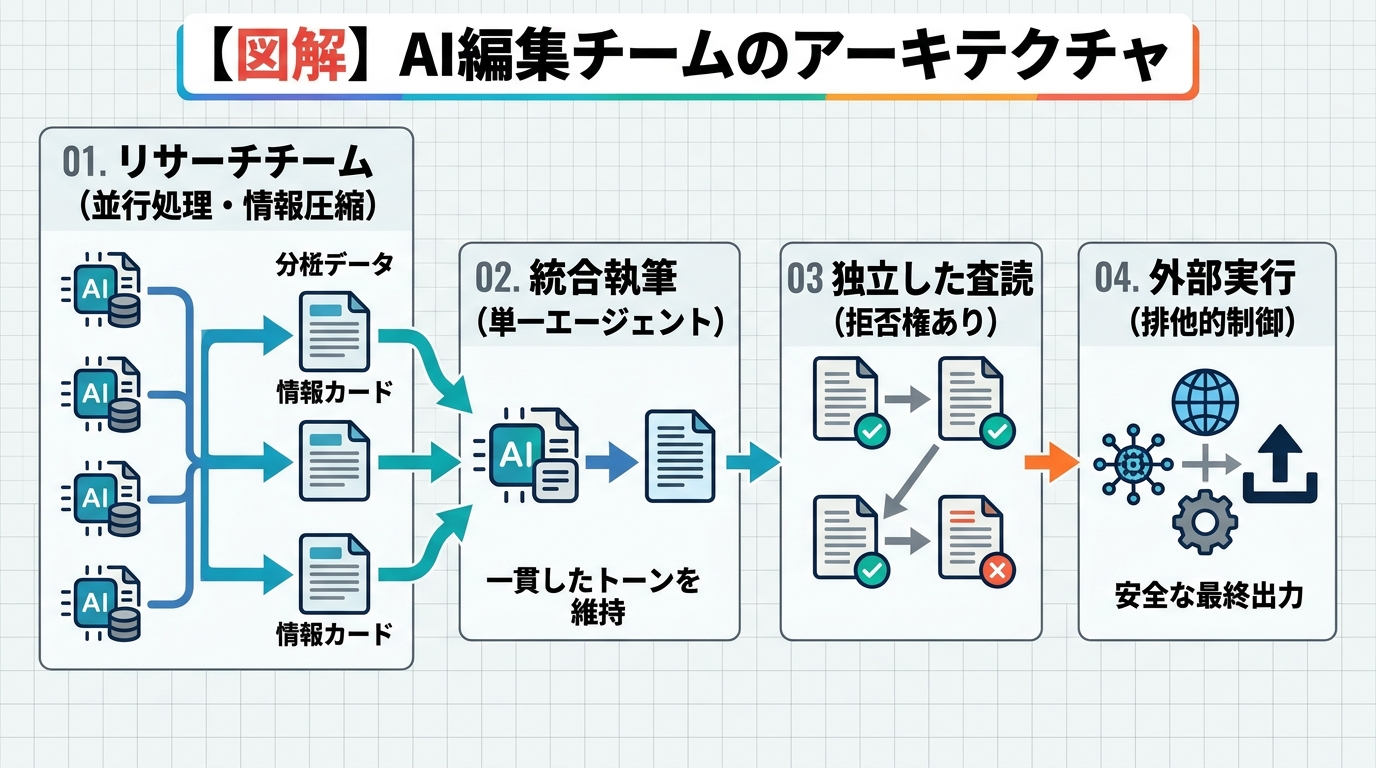
取材・構成・執筆・校閲を分離する「責任境界」の引き方
論文『MetaGPT』は、組織のSOP(標準作業手順)を取り入れ、役割ごとに構造化成果物の提出を義務づけることで連鎖的ハルシネーションを抑えました。またAnthropicの事例『How we built our multi-agent research system』では、並列調査サブエージェントの採用により単一エージェント比+90.2%の性能向上を達成しています。独立文脈でノイズを削ぎ落として要点だけを返す「並列コンテキスト圧縮」が勝因です。
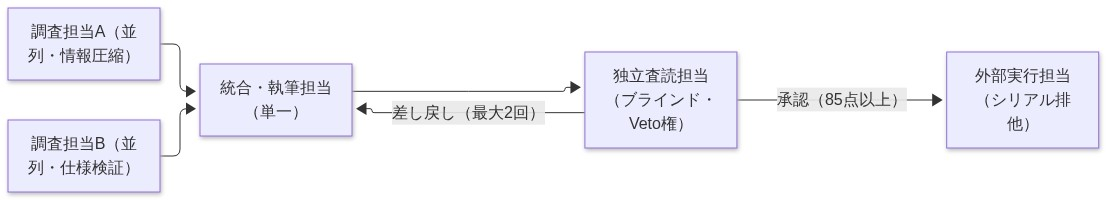
なぜ「執筆担当」だけは分割せず単一エージェントにすべきなのか
調査は並列化できますが、最終執筆を章ごとに分担すると文体や用語が乱れる「接ぎ木現象」が起きます。AnthropicのOrchestrator-Workers構成でも、探索は並列ワーカーへ委ねつつ最終統合(Synthesize)は単一エージェントが担う設計が推奨されています。
会話のバケツリレーを卒業する「共有ボード協調」の発想
長いチャット履歴を丸ごと次工程へ渡すと、試行錯誤のノイズまで引きずって精度が落ちます。代わりに「共有ボードの非同期メッセージ」や「固定スキーマの成果物(MarkdownやJSON)」を介在させ、各エージェントには自身の役割定義と確定成果物だけを渡す疎結合設計にします。
品質を劇的に安定させる「拒否権付き独立査読」と汎用設計テンプレート
生成役と評価役を分け、基準に基づく差し戻しループを回すことで出力品質は大きく安定します。
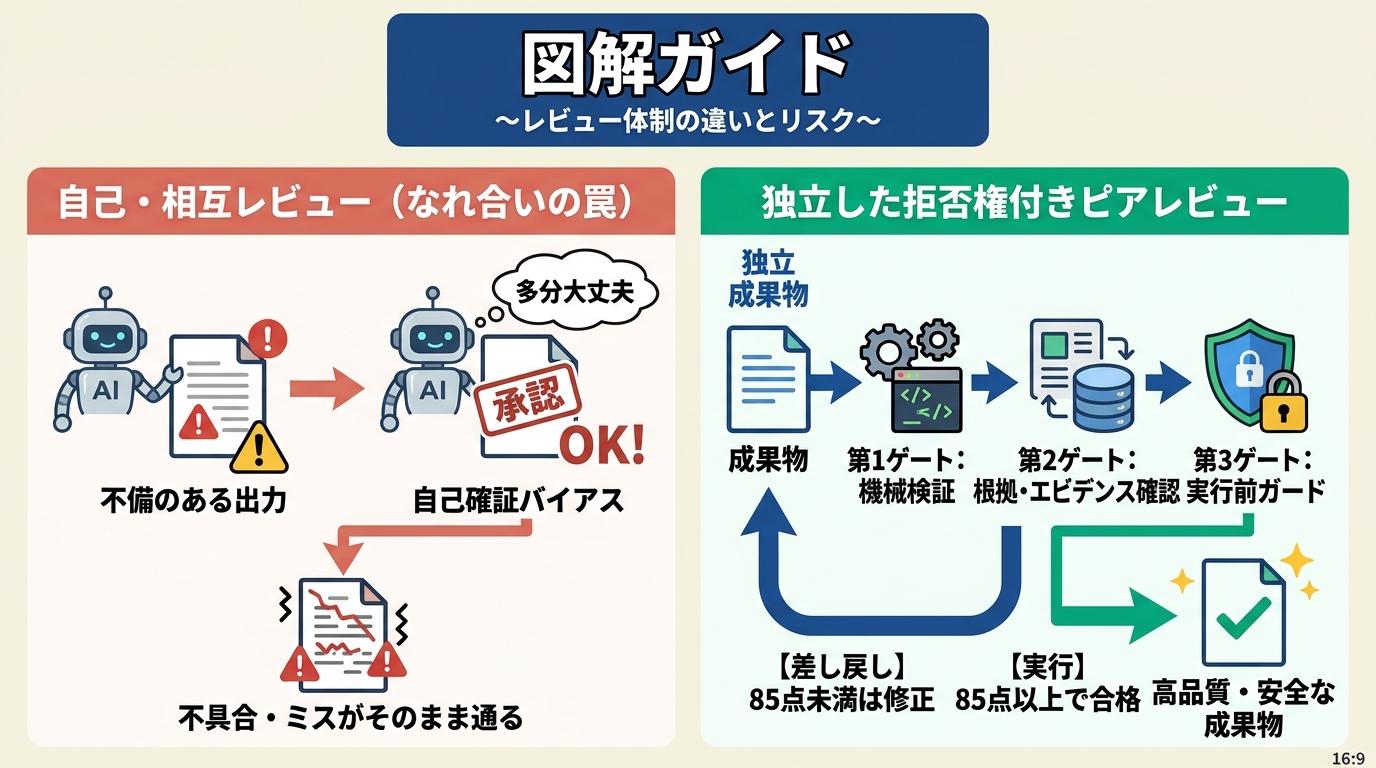
承認権限(Veto権)を持つ査読エージェントの3つの独立評価ゲート
査読役には助言ではなく、基準未達時に進行を止めるVeto権(拒否権)を持たせます。
- ゲート1:機械的契約チェック — 文字数・必須構成・機密やローカルパスの混入をプログラムで検証し、違反時はLLM査読前に即却下します。
- ゲート2:根拠・論理の独立査読 — 作成者の思考履歴を隠し、要件と成果物だけで事実根拠や論理性を減点採点します。
- ゲート3:外部実行前ガード — URL実在性や出力先整合性を確認してから後続へ渡します。
すぐに応用できる最小限のエージェント役割定義テンプレート
以下のYAMLは、Claude CodeやGemini CLI、自作スクリプトへそのまま応用できる最小定義例です。
workflow: role-separated-pipeline
context_isolation: true  # 役割定義と確定成果物のみを渡す

agents:
  researcher:
    mode: parallel       # 観点別に並列実行してコンテキストを圧縮
    owns: ["requirements", "verified_facts"]
    forbid: ["final_drafting", "external_write"]

  creator:
    mode: single         # 文体と論理の一貫性を保つため単一で統合
    owns: ["deliverable"]
    inputs: ["researcher.verified_facts", "style_guide"]

  reviewer:
    mode: independent    # creatorの思考ログを見ず成果物のみで判定
    veto_power: true     # 基準未達時は後続工程への進行を強制停止
    max_retries: 2       # 無限ループを防ぐ反復上限

  tool_executor:
    mode: serial_lock    # 外部APIやCMS等の状態変更を排他制御で直列実行
    runs_only_when: "reviewer.approved == true"
on_error: "fail_stop"ポイントはforbidによる越境禁止です。YAMLではなくMarkdown形式のプロンプト定義ファイルで運用する場合も、Owns・Forbid・Inputs・Stop Conditionの4項目を冒頭に明記すれば同じ境界制御が実現できます。
外部ツール連携を「使う瞬間だけ1体に絞る」シリアル排他制御
ブラウザ操作やCMS投稿などの状態変更ツールを複数エージェントへ開放すると競合や二重実行が起きます。外部操作は査読通過後に起動する1体のtool_executorへ直列化します。
マルチエージェント運用で必ず直面する3つの落とし穴と回避設計
役割を分けるだけでは実運用で次の3つの罠に直面するため、構造レベルの回避策を組み込みます。
落とし穴1:過剰分割によるコスト増・遅延リスク(判断基準表)
Anthropicの実測では単一自律エージェントで約4倍、並列マルチエージェントでは約15倍のトークンを消費します。タスク規模に応じた見極めが不可欠です。
| タスクの性質 | 推奨構成 | 採用すべき判断基準 |
|---|---|---|
| 短文生成・単発変換 | 単一エージェント(1体) | 1回の文脈に収まり厳格な検証が不要なタスク |
| 技術解説・コード生成 | 最小ピア構成(2体) | 作成+独立査読で品質ブレを抑えたいタスク |
| 多角調査・外部連携自動化 | 役割分離チーム(3〜4役割) | 調査の並列圧縮と副作用隔離が必要なタスク |
落とし穴2:AI同士が褒め合って素通りする「なれ合い査読」の防止策
UC Berkeleyの論文『Why Do Multi-Agent LLM Systems Fail?』(MAST研究)は、1,600件以上のトレース分析から同調バイアス(sycophancy)による査読の素通りを主要失敗因に挙げています。会話ログを隠す分離に加え、「85点未満は自動差し戻し」「改善点を最低1つ挙げる」減点ルーブリックと機械的ゲートを併用します。
落とし穴3:傷口を広げる「カスケード障害」とFail-Stop設計
上流の取得失敗やツールエラーを曖昧な仮値でごまかして続行すると、下流のAIがそれを事実と誤認し誤りが増幅します。必須条件未達時は補完せず即停止するFail-Stop原則と反復上限(max_retries: 2等)を設け、上限超過時は人間へエスカレーションします。
まとめ:プロンプトの微調整から「AI組織の設計」へのパラダイムシフト
品質安定の鍵は魔法のプロンプトではなく、役割境界・コンテキスト分離・独立査読という「組織設計」にあります。
まずは「作るAI」と「疑うAI」の2体から始める導入ステップ
最初から4役割を組む必要はありません。次の3段階で拡張するのが堅実です。
- Step 1:作成AIと独立査読AIの2体に分ける(履歴を切り離し85点未満で差し戻すだけで品質ブレが激減します)
- Step 2:コンテキストを圧迫する調査処理を切り出す(並列調査で要点だけを圧縮して渡します)
- Step 3:外部書き込み操作を末尾の1体へ隔離する(査読承認後のみ直列実行させます)
まずは「作るAI」と「疑うAI」の2体構成から、安定したエージェント運用を始めてみてください。
関連記事
動的制御によるハーネス設計や複数エージェントチームの構築例については、以下の記事もあわせてご覧ください。

コメント